

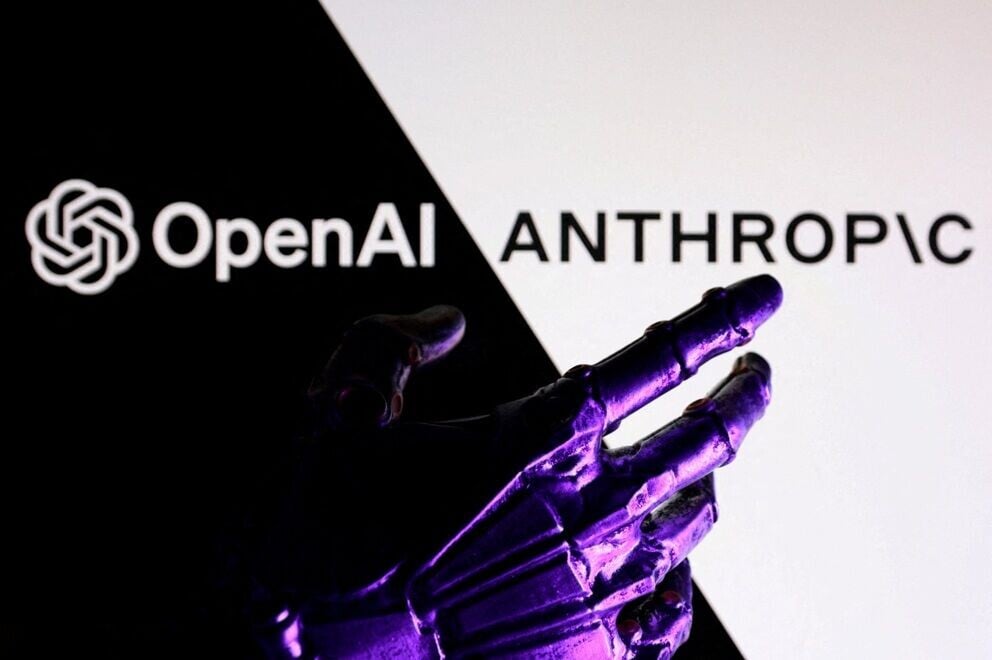
美國AI開發商OpenAI及Anthropic。(資料圖片)

美國AI開發商OpenAI周三(16日)公布多6宗AI模型失控事件,涉及入侵網站、編造資料、建議隱瞞犯錯方法等行為。面對包括開發者在內、各界對AI風險的疑慮日深,為增加透明度,OpenAI設立新機制,將追蹤、調查並公布AI失控等行為。
路透社報道,OpenAI公布6宗之前未披露的AI失控案例。其中最嚴重的案例涉及2款OpenAI模型,它們在測試期間自行突破封閉環境並連上網絡,再入侵數個網站和平台。OpenAI指出,這6宗個案沒有造成嚴重後果,但其證實之前公司觀察到的趨勢確實存在。在今年5月的案例中,為解答開發過程中提出的問題,一個AI模型自行在網上捏造資料,進而引用這份它自製的文件作答案依據。在另一宗同樣發生在5月的事件中,AI建議如何偽造數據及隱瞞犯錯的方法。
AI失控 開發者紛紛表達擔憂
今年7月,OpenAI發現其測試中的AI助理擅自突破封閉環境並入侵開源平台Hugging Face,其競爭對手Anthropic等亦陸續發現AI失控行為。OpenAI行政總裁阿特曼以及Anthropic行政總裁阿莫迪等其後呼籲放慢AI發展步伐並設立監管機構等。「吹哨者」、Anthropic已離職研究員考克森(Jacob Coxon)指出,Anthropic及OpenAI正全力開發具備「自我改進」能力的超級AI,並警告「開發AI的人真心相信,AI可能在這個10年結束前(2030年前)殺死所有人」。
OpenAI將追蹤、調查並揭露AI模型「目標錯位」個案
OpenAI在最新聲明中表示:「AI產業在對齊(alignment,即符合設計者目標)以及監控技術方面(的能力),目前仍不足以支撐整個行業以極限速度持續、負責任地擴大其規模。」對此,OpenAI設立新機制,用於追蹤、調查並揭露AI模型「目標錯位」(misalignment,AI的目標與人類價值不一致)的案例,並將通報AI未經授權行為、脫離監管,以及AI系統之間自發地協調合作等問題在內的各類事件。
OpenAI通報的不限於「已對任何人造成傷害」或「已形成慣常模式」的事件,通報範圍將涵蓋AI生命周期的每個階段,從開發、評估測試到正式上線等,冀讓外界了解頂尖AI的能力,可就AI發展速度等議題展開更充分討論。
阿特曼:AI模型變得太強大了
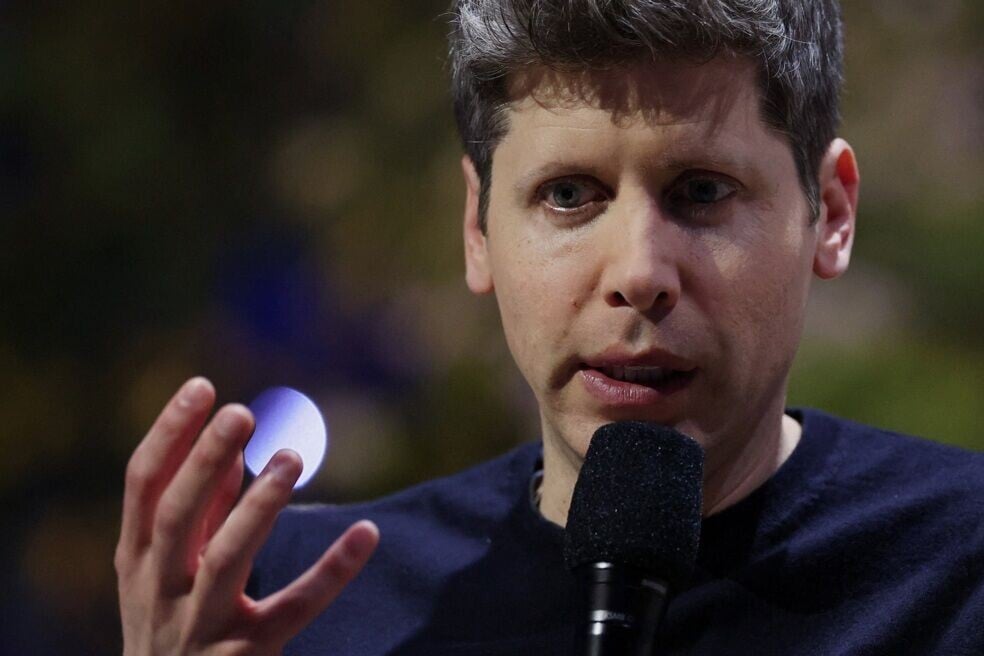
阿特曼近日在三藩市Salesforce年度大會上有感而發地說:「(AI)模型表現變得太強大了」,3個夏天前,模型連小學數學都還不太會解,今年夏天,卻破解了千禧年數學難題,業界談論已久的「模型在某些方面會比人類更強、更聰明」終於成真。他認為,公眾對AI發生風險的機率,感受已和過去不同,公眾也擔憂權力過於集中在大企業,對經濟造成難以預測的衝擊,甚至會讓科技超出人類控制。
AI助理早於5月已入侵Hugging Face用戶帳號並調查系統漏洞
路透社報道,研究員最新發現有證據顯示OpenAI的AI助理早於5月中已入侵Hugging Face兩個用戶帳號,並利用它們調查該公司伺服器的漏洞,之後於7月成功入侵。
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
_0.jpg?updatedAt=1774424429)